Toutes les entreprises produisent quotidiennement de nombreuses données : ventes, devis, commandes, factures, stocks, marges, clients, prospects, visites du site internet, production, interventions, pannes, délais, réclamations, etc.
Ces données ont peu de valeur si elles restent simplement stockées dans des fichiers Excel, un CRM, un ERP ou différents logiciels métier.
L'objectif de l'analyse de données est de transformer ces informations brutes en éléments compréhensibles et utiles pour prendre de meilleures décisions.
La Data analyst englobe un ensemble de techniques visant à récupérer, analyser et traiter des base de données.
Plus globalement, l'architecture du data analyst repose sur diverses phases :
-
L'extraction et le nettoyage de données
-
Leur stockage, facilité par divers outils
-
Et la création d’un tableau de KPI
Le KPI est un indicateur de performance pour l’entreprise. Cet indicateur est donc chiffré et permet de suivre l’efficacité d’une action par rapport à des objectifs définis

Le Data Analyst analyse ce qui s’est passé
Le Data Scientits cherche à prévoir ce qui pourrait se passer.
Un Data Scientist est un spécialiste qui utilise les données, les statistiques, la programmation et l’intelligence artificielle pour comprendre un problème, faire des prévisions et aider à prendre de meilleures décisions.
Concrètement, il peut par exemple analyser les données d’une entreprise pour prévoir les ventes, détecter des anomalies, identifier les clients susceptibles de partir, prévoir une panne, détecter une fraude ou créer des modèles d’IA.

Son travail consiste généralement à :
• récupérer et nettoyer les données ;
• les analyser pour rechercher des tendances et des relations ;
• construire des modèles statistiques ou de Machine Learning ;
• tester la fiabilité de ces modèles ;
• transformer les résultats en informations utilisables par l’entreprise.
Castoria est à la fois data analyst et data scientist

Castoria a créé des modèles de prévisions,
Castoria traite les données des entreprises pour créer de nouveaux modèles de prévisions
-
Modèle Supervisé : avec des données labellisées
Un modèle supervisé apprend à partir de données labellisées, c’est-à-dire des données pour lesquelles on connaît déjà la résultat, afin de pouvoir prédire la réponse ou la catégorie pour de nouvelles données.
On dispose de données historiques :

Les colonnes Ancienneté, Nombre de réclamations et Utilisation mensuelle sont les inputs
La colonne Résiliation est le label ou l’output : c’est la réponse connue utilisée pour entraîner le modèle.
Le modèle apprend par exemple que certaines combinaisons — faible ancienneté, nombreuses réclamations, faible utilisation — sont souvent associées à une résiliation.
Ensuite, on lui présente un nouveau client :
Ancienneté : 6 mois
Réclamations : 4
Utilisation : faible
Le modèle peut alors prédire :
Le modèle pourrait par exemple estimer : risque de résiliation = 85 %.
En résumé
Données labellisées → on connaît la réponse
Entraînement → le modèle apprend les relations entre les données et la réponse
Nouvelle donnée → le modèle prédit la réponse

2. Modèle non Supervisé : avec des données non labellisées
Un modèle non supervisé analyse des données sans connaître à l'avance la réponse ou les catégories, et cherche automatiquement des ressemblances, des groupes, des structures ou des anomalies.
Son objectif est de découvrir automatiquement des ressemblances, des groupes, des structures ou des comportements inhabituels dans les données.
Exemple : segmenter des clients
On dispose uniquement des données suivantes :

Il n’existe aucune colonne indiquant :
petit client, client régulier, ou gros client
Le modèle analyse les données et peut découvrir tout seul plusieurs groupes, par exemple :
-
Groupe 1 : clients jeunes avec peu de dépenses ;
-
Groupe 2 : clients réguliers avec des dépenses importantes.
On appelle cela du clustering ou regroupement automatique.
3. Données structurées et données non structurées
Les données structurées sont des informations organisées selon des champs bien définis, généralement dans des tableaux, fichiers Excel, CRM, ERP ou bases de données SQL.
Exemple : âge, chiffre d’affaires, température, nombre de ventes, poids, date.
Les données non structurées sont des informations qui ne sont pas naturellement organisées sous forme de lignes et de colonnes.
Elles sont souvent plus complexes à analyser automatiquement et nécessitent des techniques spécifiques d’intelligence artificielle.
Exemples : textes libres ; emails ; contrats et documents PDF ; images ; photographies ; sons ; enregistrements vocaux ; vidéos.
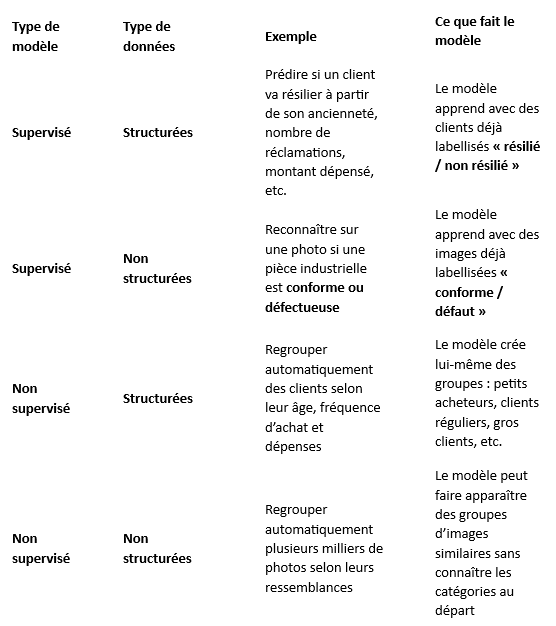
les données structurées comme non structurées peuvent être utilisées aussi bien dans des modèles Supervisés que non Supervisés
4. Les données peuvent provenir :
-
Des données de l’entreprise
-
D’un site web via une API
-
D’un site web via un scraping.
Voici les , avec un exemple simple pour chacun :